

Wie eine Personalisierungs-Engine wirklich entscheidet, was jeder Besucher sieht

Jedes Personalisierungstool beschreibt sich mit denselben Substantiven — Profile, Segmente, Empfehlungen, Tests —, und fast keines erklärt den einzigen Moment, auf den es ankommt: die paar Millisekunden, nachdem ein Besucher eine Seite angefordert hat und die Engine entscheiden muss, was genau diese Person sieht. Das ist kein einzelner Trick. Es sind mehrere Ebenen, jede mit Regeln, die der Websitebetreiber festlegt, und die Antwort für diesen Besucher auf dieser Seite ergibt sich aus allen gleichzeitig. Hier ein Gang durch diese Ebenen in der Reihenfolge, in der sie wirken – innerhalb von Personyze.
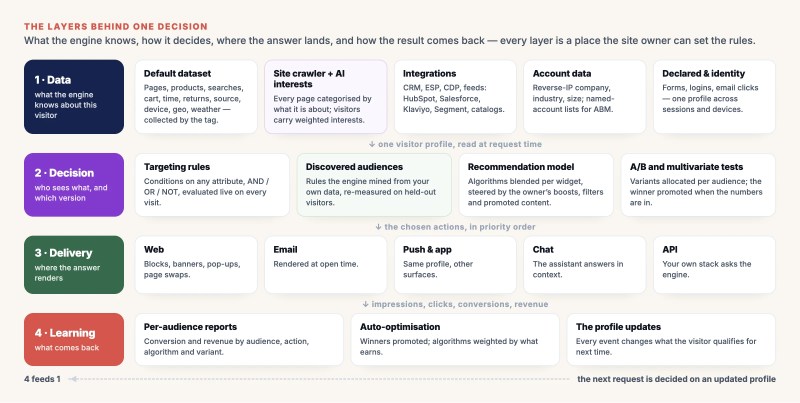
Vier Ebenen, eine Entscheidung. Jedes Kästchen ist eine Stelle, an der der Websitebetreiber die Regeln festlegt — welche Daten hereinkommen, wie sie gewichtet werden, wo die Antwort landet und was gemessen wird.
1. Die Datenebene: was die Engine weiß
Über einen Besucher, über den die Engine nichts weiß, lässt sich nichts entscheiden. Die erste Ebene ist also das, was sie sammelt, und woher. Das meiste kommt an, ohne dass jemand etwas konfiguriert; der Rest ist die Wahl des Websitebetreibers.
- Der Standard-Datensatz. Das Tag auf Ihren Seiten erfasst, was jeder Besucher tut — angesehene Seiten und Produkte, Suchen auf der Website, Warenkorbinhalt und -wert, Verweildauer, Scrollen, Wiederkehr, Anzahl der Besuche, Referrer und Kampagne, Gerät, Standort, lokales Wetter und Uhrzeit. Das ist die Grundlage, die jede andere Ebene liest, und sie ist ab dem ersten Seitenaufruf aktiv.
- Der Website-Crawler und automatische Interessen. Personyze crawlt Ihre Website und ordnet jede Seite per KI danach ein, worum es darin wirklich geht — kontextbezogen, in den Begriffen Ihrer eigenen Website statt in einer generischen Taxonomie. Ein Besucher, der Produkte in der Kategorie religiöse Geschenke ansieht, trägt „religiöse Geschenke“ als Interesse, gewichtet danach, wie viel er angesehen hat. Dadurch versteht die Engine, was eine Seite für eine Person bedeutet, statt nur zu wissen, dass sie gesehen wurde, und dieselben Interessen speisen Targeting, Empfehlungen und die Zielgruppenerkennung.
- Integrationen. Beim Onboarding verbinden Sie, was Sie bereits haben: CRM und ESP (HubSpot, Salesforce, Klaviyo, ActiveCampaign und weitere), eine CDP oder einen Tag-Manager, Produkt- und Content-Feeds sowie Ihre eigenen Events über die API. Jede Quelle wird zu Attributen im Profil, die Regeln und Modelle nutzen können — die Liste finden Sie auf der Seite zu den Integrationen im Überblick.
- Account-Daten. Auf B2B-Websites erkennt ein Reverse-IP-Lookup das Unternehmen hinter einem anonymen Besuch — Branche, Größe, Name —, und mit Listen benannter Accounts können Account-Based-Marketing-Kampagnen einen Ziel-Account schon ab der ersten Seite anders behandeln.
- Angegebene Daten und Identität. Formulare, Logins und E-Mail-Klicks verknüpfen Sitzungen und Geräte mit einer Person, sodass das, was die Engine letzte Woche auf dem Laptop gelernt hat, heute auf dem Smartphone gilt.
Der Kern dieser Ebene ist Wahlfreiheit: Welche Datengruppen die Engine nutzen darf, ist eine Reihe von Schaltern, und die Berichte zeigen, welche Gruppen die Entscheidungen tatsächlich getragen haben.
2. Das Profil: ein Besucher, ein Datensatz — und der bisherige Besuch

Die Reihenfolge zum Zeitpunkt der Anfrage. Zuerst wird das Profil gelesen, dann entscheiden Zielgruppen und Modelle, die Antwort wird ausgespielt, und das Ergebnis wird für die nächste Anfrage zurückgeschrieben.
Zum Zeitpunkt der Anfrage ermittelt die Engine, wer fragt, und liest einen zusammengeführten Datensatz: das Verhalten von oben, die vom Crawler zugeordneten Interessen, die CRM-Felder, das Unternehmen, die Listen, auf denen der Besucher steht — und, ganz entscheidend, was er bei diesem Besuch getan hat. Ein Besucher, der gerade nach „Großhandel“ gesucht, sechs Produkte angesehen und einen Warenkorb verlassen hat, ist ein anderer Mensch als der, der vor fünf Minuten ankam, und jede Ebene darunter liest das Profil so, wie es jetzt ist, nicht wie es gestern Abend war.
Deshalb kann eine Regel lauten: Branche ist Finanzen und angesehene Produkte mindestens sechs – ganz gleich, ob die eine Angabe aus ZoomInfo und die andere aus der aktuellen Sitzung stammt.
3. Targeting: wer dieser Besucher gerade ist
Mit dem Profil in der Hand wertet die Engine Targeting-Regeln aus — live, bei jedem Besuch, nicht gegen eine Momentaufnahme. Drei Arten von Zielgruppen fließen in diesen Schritt ein:
- Regeln, die Sie geschrieben haben. Bedingungen auf jedes Attribut im Profil, verknüpft mit UND, ODER und NICHT. Das ist Behavioral Targeting so, wie die meisten Teams es kennen: Warenkorbabbrecher, wiederkehrende VIPs, erster Besuch über eine bezahlte Anzeige, ein Unternehmen auf der Liste der Ziel-Accounts.
- Listen, die Sie importiert oder aufgebaut haben. Namentlich bekannte Personen aus einem CRM-Export, einem Feed oder einer früheren Kampagne, nach Zeitplan aktualisiert und für E-Mail, Push und Offline-Kampagnen ebenso nutzbar wie auf der Website.
- Zielgruppen, die die Engine entdeckt hat. Einmal pro Woche — oder wann immer Sie auf „Jetzt einen Durchlauf starten“ klicken — Audience Discovery liest die eigenen Besucherdaten des Kontos und findet kurze Regeln für Besucher, die ein Ziel weit häufiger als der Durchschnitt erreichen, erneut gemessen an Besuchern, die die Regel nie gesehen hat. Jeder Fund ist eine Karte, die Sie mit einem Klick ansprechen, in jeder Kampagne aus der Kategorie Entdeckte Zielgruppen auswählen, in eine Liste umwandeln oder in eine eigene Zielgruppe kopieren können.

Entdeckte Zielgruppen kommen in den Targeting-Schritt wie jede von Hand geschriebene Regel: eine Live-Bedingung, ausgewertet pro Besucher und pro Anfrage. Beispielkonto.
Welcher Art sie auch ist: Die Zielgruppe ist eine Frage, die die Engine bei dieser Anfrage über diesen Besucher stellt. Ein Besucher, der mitten in der Sitzung eine Schwelle überschreitet, gehört schon auf der nächsten Seite zur Zielgruppe.
4. Das Empfehlungsmodell: was gezeigt wird und wie der Betreiber es steuert
Empfehlungen sind eine eigene Entscheidung innerhalb der Entscheidung. Ein Widget auf einer Produktseite, eine Leiste im Warenkorb, ein „Weiterlesen“-Block unter einem Artikel und ein Produktraster in einer E-Mail führen jeweils ein Modell aus, das Einträge für diesen Besucher in diesem Moment sortiert — und das Modell ist nicht ein Algorithmus, sondern eine Auswahl davon, gemischt, mit Einstellungen, die der Websitebetreiber steuert.

Der Algorithmus wird pro Seite gewählt, weil sich der Anker ändert: das aktuelle Produkt auf einer Produktseite, zuletzt angesehene Artikel auf der Startseite, der Warenkorbinhalt im Warenkorb. Beispielkonto.
- Die Algorithmen. Personalisierte Vorschläge auf Basis der Interessen des Besuchers und des Verhaltens ähnlicher Besucher; beliebteste Artikel, Trends und Bestseller, optional aus der Kategorie, die der Besucher gerade angesehen hat; zusammen angesehen, zusammen gekauft und Upsells, verankert am angezeigten Produkt oder am Warenkorb; Besucherverlauf wie zuletzt angesehen und wieder vorrätig; Katalogereignisse wie Neuheiten und Preissenkungen; und ein eigener Algorithmus, den Sie selbst definieren. Den vollständigen Satz finden Sie auf der Seite zur Empfehlungs-Engine im Überblick.
- Die Einstellungen des Betreibers. Hier lebt die Geschäftslogik einer Website. Ein Verlag kann beworbene oder gesponserte Inhalte stärker gewichten; ein Händler kann eine Kategorie hervorheben, nicht Vorrätiges oder bereits Gekauftes ausschließen, die Preisspanne begrenzen und einen Artikel auf Platz eins festsetzen. Gewichte pro Algorithmus bestimmen die Mischung; Filter bestimmen, was überhaupt erscheinen darf.
- Pro Zielgruppe. Dasselbe Widget kann für verschiedene Zielgruppen unterschiedliche Logik ausführen — Complete-the-Look für wiederkehrende Käufer, Bestseller für Erstbesucher —, weil der Targeting-Schritt bereits geklärt hat, wer das ist.
- Vom Besuch gesteuert. Die Interessen aus dieser Sitzung verändern die Sortierung sofort: Ein Besucher, der gerade drei Artikel einer Kategorie angesehen hat, sieht diese Kategorie stärker gewichtet, noch bevor er die aktuelle Seite verlässt.
5. Testen und Optimieren: welche Variante, für wen
Ist eine Kampagne ein Experiment, findet hier die Zuteilung statt. Personyze teilt pro Zielgruppe zu und entscheidet pro Zielgruppe – das ist der Unterschied zwischen zielgruppenorientiertem A/B-Testing und der websiteweiten Variante: Eine Variante kann bei wiederkehrenden Käufern gewinnen und bei Erstbesuchern verlieren, und die Engine kann sie für die erste Gruppe übernehmen, während der Test für die zweite weiterläuft. Multivariate Tests tun dasselbe über mehrere Elemente gleichzeitig, und Empfehlungsalgorithmen lassen sich auf derselben Platzierung gegeneinander testen, gemessen am Umsatz pro Sitzung statt an Klicks.
Auch die Umgebung zählt. Eine Kampagne wird im Staging gebaut und in der Vorschau geprüft, live geschaltet, wenn sie fertig ist, und nach Traffic-Anteil aufgeteilt, damit eine neue Idee erst auf einem Teil laufen kann, bevor sie für alle läuft. Liegen die Zahlen vor, übernimmt der Gewinner automatisch den Traffic.
6. Die Ausspielung: so schnell, dass es niemand merkt
Erst jetzt erscheint etwas. Die gewählten Aktionen werden über das Tag auf Ihrer eigenen Website in der Seite ausgespielt, serverseitig auf einer dynamischen Landingpage, in einer E-Mail im Moment des Öffnens, als Push-Benachrichtigung, im Chatverlauf, über die API für Ihren eigenen Stack oder als Event an Meta, TikTok, Google Analytics und die übrigen der zwölf Ziele, die der Event-Sender erreicht — und die gesamte Kette oben muss schneller fertig sein, als die Seite lädt. Nichts wartet auf einen Batch-Job: Die Auswertung hinter der Erkennung lief vor Tagen, die Listen wurden über Nacht aktualisiert, und die Entscheidung selbst wird zum Zeitpunkt der Anfrage aus dem Live-Profil berechnet.
7. Lernen: was zurückkommt
Die letzte Ebene speist die erste. Jede Impression, jeder Klick und jede Conversion wird ins Profil zurückgeschrieben und verändert, wofür der Besucher bei der nächsten Anfrage infrage kommt. Kampagnenberichte zeigen Ergebnisse pro Zielgruppe, pro Aktion, pro Algorithmus und pro Variante, nicht nur pro Kampagne, sodass die Frage „Hat das funktioniert?“ für jede Gruppe, der es gezeigt wurde, eine Antwort hat. Gewinner werden übernommen; Algorithmen werden nach dem gewichtet, was sie einbringen.

Dieselbe Ehrlichkeit gilt für das, was die Engine selbst gefunden hat: Prognostizierter und tatsächlich erzielter Lift werden getrennt ausgewiesen, und ein Trichter zählt, welche Zielgruppen angelegt, befüllt und tatsächlich genutzt wurden. Beispielkonto.
Warum die Ebenen wichtig sind
Anbieter, die aus einem Testing-Tool entstanden sind, beginnen meist auf Ebene fünf; Anbieter, die aus einem Empfehlungs-Widget entstanden sind, beginnen auf Ebene vier. Beide setzen nachträglich ein Profil darauf, weshalb ihr „Full Stack“ ein Integrationsprojekt braucht, um sich wie ein System zu verhalten. Bei den Daten zu beginnen — standardmäßig erfasst, vom Crawler verstanden, durch Ihre Integrationen erweitert — macht jede spätere Ebene günstig: Targeting-Regel, Empfehlungsmischung, Test und Bericht lesen alle dasselbe Profil, und der Websitebetreiber legt auf jeder Ebene die Regeln fest.
- Die Personalisierungsplattform — ein Profil, eine Engine, jeder Einsatzzweck.
- Behavioral Targeting — die Regeln, die Trigger, die Kanäle.
- Die Empfehlungs-Engine — die Algorithmen und die Einstellungen, die sie steuern.
- Zielgruppenorientiertes A/B-Testing — Zuteilung und Entscheidung pro Zielgruppe.
- Audience Discovery — die Zielgruppen, die die Engine in Ihren eigenen Daten findet.
- Demo buchen — sehen Sie die Entscheidung auf Ihren eigenen Seiten.
Book a demo with a personalization expert
30 minutes with a personalization expert. Bring your stack, your goals, your skepticism. We'll show you what changes when every visit feels like the only one.