

Como um mecanismo de personalização decide de fato o que cada visitante vê

Toda ferramenta de personalização se descreve com os mesmos substantivos — perfis, segmentos, recomendações, testes — e quase nenhuma explica o único momento que importa: os poucos milissegundos depois que um visitante pede uma página, quando o mecanismo precisa decidir o que aquela pessoa vê. Não é um truque só. São várias camadas, cada uma com regras que o dono do site define, e a resposta para este visitante nesta página sai de todas elas ao mesmo tempo. Este é um passeio por essas camadas na ordem em que agem dentro da Personyze.
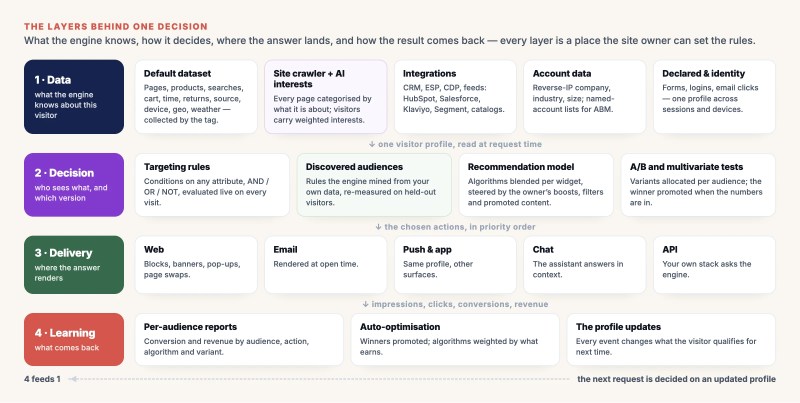
Quatro camadas, uma decisão. Cada caixa é um ponto em que o dono do site define as regras — quais dados entram, como são ponderados, onde a resposta chega e o que é medido.
1. A camada de dados: o que o mecanismo sabe
Não dá para decidir nada sobre um visitante de quem o mecanismo não sabe nada, então a primeira camada é o que ele coleta, e de onde. A maior parte chega sem que ninguém configure nada; o resto é escolha do dono do site.
- O conjunto de dados padrão. A tag nas suas páginas registra o que cada visitante faz — páginas e produtos vistos, buscas no site, conteúdo e valor do carrinho, tempo no site, rolagem, retornos, número de visitas, referenciador e campanha, dispositivo, localização, clima e hora locais. É a base que todas as outras camadas leem, e ela está ativa desde a primeira visualização de página.
- O rastreador do site e os interesses automáticos. A Personyze rastreia o seu site e usa IA para classificar cada página pelo assunto de fato — de forma contextual, nos termos do seu próprio site, e não numa taxonomia genérica. Um visitante que vê produtos na categoria de presentes religiosos passa a ter “presentes religiosos” como interesse, ponderado por quanto viu. É isso que permite ao mecanismo entender o que uma página significa para uma pessoa, e não só que ela foi vista, e esses mesmos interesses alimentam a segmentação, as recomendações e a descoberta de públicos.
- Integrações. Durante o onboarding você conecta o que já tem: o CRM e o ESP (HubSpot, Salesforce, Klaviyo, ActiveCampaign e os demais), uma CDP ou gerenciador de tags, feeds de produtos e conteúdo, e os seus próprios eventos pela API. Cada um vira atributos no perfil que regras e modelos podem usar — veja a página de integrações para a lista.
- Dados de contas. Em sites B2B, a consulta de IP reverso identifica a empresa por trás de uma visita anônima — setor, porte, nome — e listas de contas nomeadas permitem que campanhas de marketing baseado em contas tratem uma conta-alvo de forma diferente desde a primeira página.
- Dados declarados e identidade. Formulários, logins e cliques em e-mails ligam sessões e dispositivos a uma só pessoa, então o que o mecanismo aprendeu no notebook na semana passada vale hoje no celular.
O ponto dessa camada é a escolha: quais grupos de dados o mecanismo pode usar é um conjunto de interruptores, e os relatórios mostram quais grupos de fato sustentaram as decisões.
2. O perfil: um visitante, um registro — e a visita até aqui

A ordem no momento da requisição. Primeiro o perfil é lido, depois públicos e modelos decidem, a resposta é renderizada e o resultado é gravado de volta para a próxima requisição.
No momento da requisição, o mecanismo identifica quem está pedindo e lê um único registro unificado: o comportamento acima, os interesses atribuídos pelo rastreador, os campos do CRM, a empresa, as listas de que o visitante faz parte — e, principalmente, o que ele fez nesta visita. Um visitante que acabou de buscar “atacado”, viu seis produtos e abandonou um carrinho é uma pessoa diferente daquela que chegou cinco minutos atrás, e cada camada abaixo lê o perfil como ele está agora, e não como estava ontem à noite.
É por isso que uma regra pode dizer setor igual a finanças e produtos vistos pelo menos seis sem se importar que uma informação veio do ZoomInfo e a outra da sessão atual.
3. Segmentação: quem é este visitante, agora
Com o perfil em mãos, o mecanismo avalia as regras de segmentação — ao vivo, a cada visita, e não contra um retrato estático. Três tipos de público alimentam essa etapa:
- Regras que você escreveu. Condições sobre qualquer atributo do perfil, combinadas com E, OU e NÃO. É a segmentação comportamental como a maioria das equipes conhece: quem abandona o carrinho, VIPs que voltam, primeira visita vinda de anúncio pago, uma empresa na lista de contas-alvo.
- Listas que você importou ou montou. Pessoas identificadas vindas de uma exportação do CRM, de um feed ou de uma campanha anterior, atualizadas conforme agenda e utilizáveis em e-mail, push e campanhas offline tanto quanto no site.
- Públicos que o mecanismo descobriu. Uma vez por semana — ou sempre que você clicar em “Executar uma rodada agora” — Descoberta de públicos lê os dados de visitantes da própria conta e encontra regras curtas para os visitantes que atingem um resultado com frequência muito maior que a média, medidas de novo em visitantes que a regra nunca viu. Cada descoberta é um cartão que você pode segmentar com um clique, escolher na categoria Públicos descobertos em qualquer campanha, transformar em lista ou copiar para um público seu.

Os públicos descobertos entram na etapa de segmentação como qualquer regra escrita à mão: uma condição ao vivo, avaliada por visitante e por requisição. Conta ilustrativa.
Seja de que tipo for, o público é uma pergunta que o mecanismo faz sobre este visitante nesta requisição. Um visitante que cruza um limite no meio da sessão já está no público na página seguinte.
4. O modelo de recomendação: o que mostrar e como o dono o conduz
Recomendações são uma decisão própria dentro da decisão. Um widget numa página de produto, uma faixa no carrinho, um bloco “leia também” embaixo de um artigo e uma grade de produtos num e-mail rodam cada um um modelo que ordena itens para este visitante neste momento — e o modelo não é um algoritmo, mas uma escolha entre vários, combinados, com configurações que o dono do site controla.

O algoritmo é escolhido por página, porque a âncora muda: o produto atual numa página de produto, os itens vistos recentemente na home, o conteúdo do carrinho no carrinho. Conta ilustrativa.
- Os algoritmos. Seleções personalizadas com base nos interesses do visitante e no comportamento de visitantes parecidos; mais populares, em alta e mais vendidos, opcionalmente da categoria que o visitante estava vendo; vistos juntos, comprados juntos e upsells ancorados no produto em exibição ou no carrinho; histórico do visitante, como vistos recentemente e de volta ao estoque; eventos do catálogo, como novidades e quedas de preço; e um algoritmo personalizado que você mesmo define. Veja a página do mecanismo de recomendação para o conjunto completo.
- As configurações do dono. É aqui que mora a lógica de negócio de um site. Um publisher pode dar mais peso a conteúdo promovido ou patrocinado; um varejista pode impulsionar uma categoria, excluir o que está sem estoque ou já foi comprado, limitar a faixa de preço e fixar um item na primeira posição. Os pesos por algoritmo definem a mistura; os filtros definem o que pode aparecer.
- Por público. O mesmo widget pode rodar lógicas diferentes para públicos diferentes — complete o look para compradores recorrentes, mais vendidos para quem visita pela primeira vez — porque a etapa de segmentação já disse quem é.
- Conduzido pela visita. Os interesses desta sessão mudam a ordenação na hora: um visitante que acabou de ver três itens de uma categoria vê essa categoria com mais peso antes mesmo de sair da página em que está.
5. Testes e otimização: qual variação, para quem
Se uma campanha é um experimento, a alocação acontece aqui. A Personyze aloca por público e decide por público, e essa é a diferença entre testes A/B centrados no público e os testes para o site inteiro: uma variação pode vencer com compradores recorrentes e perder com quem chega pela primeira vez, e o mecanismo pode promovê-la para o primeiro grupo enquanto o teste continua para o segundo. Testes multivariados fazem o mesmo com vários elementos ao mesmo tempo, e algoritmos de recomendação podem ser testados uns contra os outros no mesmo posicionamento, medidos por receita por sessão em vez de cliques.
O ambiente também importa. Uma campanha é criada e pré-visualizada em staging, publicada quando está pronta e dividida por porcentagem de tráfego, para que uma ideia nova rode numa fatia antes de rodar para todos. Quando os números chegam, a vencedora fica com o tráfego automaticamente.
6. A renderização: rápida o bastante para ninguém perceber
Só agora algo aparece. As ações escolhidas são renderizadas na página pela tag do seu próprio site, no servidor numa landing page dinâmica, dentro de um e-mail no momento em que é aberto, como notificação push, na conversa do chat, pela API para o seu próprio stack, ou como evento para Meta, TikTok, Google Analytics e o restante dos doze destinos que o event sender alcança — e toda a cadeia acima precisa terminar antes de a página carregar. Nada espera por um processamento em lote: a mineração por trás da descoberta rodou dias atrás, as listas foram atualizadas durante a noite e a decisão em si é calculada no momento da requisição a partir do perfil ao vivo.
7. Aprendizado: o que volta
A última camada alimenta a primeira. Cada impressão, clique e conversão é gravado de volta no perfil, o que muda aquilo para o que o visitante se qualifica na próxima requisição. Os relatórios de campanha mostram resultados por público, por ação, por algoritmo e por variação, não só por campanha, então a pergunta “isso funcionou?” tem resposta para cada grupo a que foi exibido. Vencedores são promovidos; algoritmos são ponderados pelo que rendem.

A mesma honestidade vale para o que o mecanismo encontrou sozinho: o lift previsto e o lift realizado aparecem separados, e um funil conta quais públicos foram criados, preenchidos e de fato usados. Conta ilustrativa.
Por que as camadas importam
Fornecedores que nasceram de uma ferramenta de testes costumam começar na camada cinco; os que nasceram de um widget de recomendação começam na camada quatro. Os dois acoplam um perfil depois, e é por isso que o “full stack” deles precisa de um projeto de integração para funcionar como um só sistema. Começar pelos dados — coletados por padrão, compreendidos pelo rastreador, ampliados pelas suas integrações — é o que torna barata cada camada seguinte: a regra de segmentação, a mistura de recomendações, o teste e o relatório leem o mesmo perfil, e o dono do site define as regras em cada um deles.
- A plataforma de personalização — um perfil, um mecanismo, todas as jogadas.
- Segmentação comportamental — as regras, os gatilhos, os canais.
- O mecanismo de recomendação — os algoritmos e as configurações que os conduzem.
- Testes A/B centrados no público — alocação e decisão por público.
- Descoberta de públicos — os públicos que o mecanismo encontra nos seus próprios dados.
- Agendar uma demo — veja a decisão tomada nas suas próprias páginas.
Book a demo with a personalization expert
30 minutes with a personalization expert. Bring your stack, your goals, your skepticism. We'll show you what changes when every visit feels like the only one.