

Hoe een personalisatie-engine echt beslist wat elke bezoeker ziet

Elke personalisatietool beschrijft zichzelf met dezelfde zelfstandige naamwoorden — profielen, segmenten, aanbevelingen, tests — en bijna geen enkele legt het enige moment uit dat ertoe doet: de paar milliseconden nadat een bezoeker een pagina opvraagt, als de engine moet beslissen wat die ene persoon ziet. Het is niet één truc. Het zijn meerdere lagen, elk met regels die de site-eigenaar instelt, en het antwoord voor deze bezoeker op deze pagina komt uit al die lagen tegelijk. Dit is een rondgang langs die lagen in de volgorde waarin ze werken binnen Personyze.
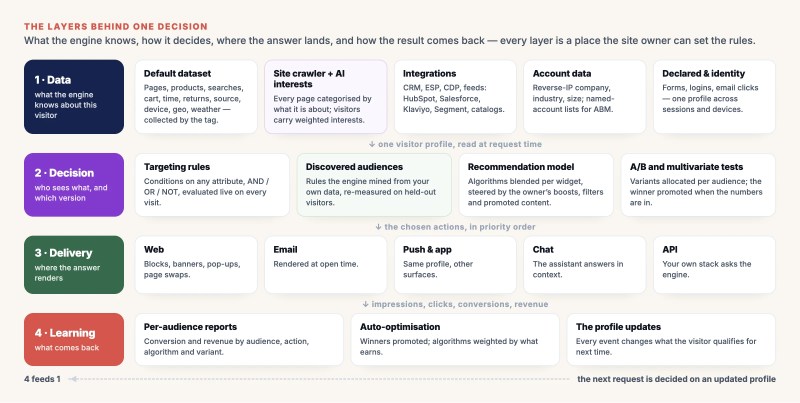
Vier lagen, één beslissing. Elk vak is een plek waar de site-eigenaar de regels bepaalt — welke data binnenkomt, hoe die wordt gewogen, waar het antwoord terechtkomt en wat er wordt gemeten.
1. De datalaag: wat de engine weet
Over een bezoeker van wie de engine niets weet, valt niets te beslissen, dus de eerste laag is wat hij verzamelt, en waarvandaan. Het meeste komt binnen zonder dat iemand iets configureert; de rest is de keuze van de site-eigenaar.
- De standaarddataset. De tag op je pagina’s legt vast wat elke bezoeker doet — bekeken pagina’s en producten, zoekopdrachten op de site, inhoud en waarde van het winkelmandje, tijd op de site, scrollen, terugkeren, het aantal bezoeken, verwijzer en campagne, apparaat, locatie, lokaal weer en tijd. Dit is de basis die elke andere laag leest, en die staat aan vanaf de eerste paginaweergave.
- De sitecrawler en automatische interesses. Personyze crawlt je site en gebruikt AI om elke pagina in te delen naar waar die echt over gaat — contextueel, in de termen van je eigen site, geen generieke taxonomie. Een bezoeker die producten in de categorie religieuze cadeaus bekijkt, krijgt “religieuze cadeaus” als interesse, gewogen naar hoeveel hij bekeek. Hierdoor begrijpt de engine wat een pagina voor iemand betekent in plaats van alleen dat hij is gezien, en dezelfde interesses voeden targeting, aanbevelingen en doelgroepontdekking.
- Integraties. Tijdens de onboarding koppel je wat je al hebt: het CRM en de ESP (HubSpot, Salesforce, Klaviyo, ActiveCampaign en de rest), een CDP of tagmanager, product- en contentfeeds, en je eigen events via de API. Elk ervan wordt kenmerken in het profiel die regels en modellen kunnen gebruiken — zie de pagina over integraties voor de lijst.
- Accountdata. Voor B2B-sites herkent een reverse-IP-lookup het bedrijf achter een anoniem bezoek — branche, omvang, naam — en met lijsten van benoemde accounts kunnen accountgebaseerde marketingcampagnes een doelaccount vanaf de eerste pagina anders behandelen.
- Opgegeven data en identiteit. Formulieren, logins en klikken in e-mails koppelen sessies en apparaten aan één persoon, zodat wat de engine vorige week op de laptop leerde vandaag op de telefoon geldt.
Het punt van deze laag is keuze: welke datagroepen de engine mag gebruiken, is een reeks schakelaars, en de rapporten laten zien welke groepen de beslissingen echt droegen.
2. Het profiel: één bezoeker, één record — en het bezoek tot nu toe

De volgorde op het moment van het verzoek. Eerst wordt het profiel gelezen, dan beslissen doelgroepen en modellen, het antwoord wordt weergegeven en het resultaat wordt teruggeschreven voor het volgende verzoek.
Op het moment van het verzoek bepaalt de engine wie er vraagt en leest hij één samengevoegd record: het gedrag hierboven, de interesses die de crawler toekende, de CRM-velden, het bedrijf, de lijsten waar de bezoeker op staat — en, cruciaal, wat hij heeft gedaan tijdens dit bezoek. Een bezoeker die net op “groothandel” heeft gezocht, zes producten heeft bekeken en een winkelmandje heeft achtergelaten, is een ander persoon dan degene die vijf minuten geleden binnenkwam, en elke laag hieronder leest het profiel zoals het nu is, niet zoals het gisteravond was.
Daarom kan een regel zeggen branche is gelijk aan financiën en bekeken producten minstens zes zonder zich erom te bekommeren dat het ene gegeven uit ZoomInfo kwam en het andere uit de huidige sessie.
3. Targeting: wie deze bezoeker nu is
Met het profiel in handen evalueert de engine targetingregels — live, bij elk bezoek, niet tegen een momentopname. Drie soorten doelgroepen voeden deze stap:
- Regels die jij schreef. Voorwaarden op elk kenmerk in het profiel, gecombineerd met EN, OF en NIET. Dit is gedragsgerichte targeting zoals de meeste teams die kennen: winkelmandverlaters, terugkerende VIP’s, een eerste bezoek via een betaalde advertentie, een bedrijf op de lijst met doelaccounts.
- Lijsten die je importeerde of opbouwde. Benoemde personen uit een CRM-export, een feed of een eerdere campagne, volgens schema ververst en even goed bruikbaar voor e-mail, push en offline campagnes als op de site.
- Doelgroepen die de engine ontdekte. Eens per week — of wanneer je op “Nu een ronde draaien” drukt — Doelgroepontdekking leest de eigen bezoekersdata van het account en vindt korte regels voor de bezoekers die veel vaker dan gemiddeld een doel bereiken, opnieuw gemeten op bezoekers die de regel nooit zag. Elke bevinding is een kaart waarop je met één klik kunt targeten, die je in elke campagne kunt kiezen uit de categorie Ontdekte doelgroepen, die je in een lijst kunt omzetten of kunt kopiëren naar een eigen doelgroep.

Ontdekte doelgroepen komen in de targetingstap terecht zoals elke handgeschreven regel: een live voorwaarde, per bezoeker en per verzoek geëvalueerd. Voorbeeldaccount.
Welke soort het ook is, de doelgroep is een vraag die de engine over deze bezoeker bij dit verzoek stelt. Een bezoeker die midden in een sessie een drempel passeert, zit op de allervolgende pagina in de doelgroep.
4. Het aanbevelingsmodel: wat er getoond wordt, en hoe de eigenaar het stuurt
Aanbevelingen zijn een eigen beslissing binnen de beslissing. Een widget op een productpagina, een strook in het winkelmandje, een “lees verder”-blok onder een artikel en een productraster in een e-mail draaien elk een model dat items rangschikt voor deze bezoeker op dit moment — en het model is niet één algoritme, maar een keuze daaruit, gemengd, met instellingen die de site-eigenaar beheert.

Het algoritme wordt per pagina gekozen, omdat het anker verandert: het huidige product op een productpagina, recent bekeken items op de homepage, de inhoud van het winkelmandje in het mandje. Voorbeeldaccount.
- De algoritmen. Gepersonaliseerde keuzes op basis van de interesses van de bezoeker en het gedrag van vergelijkbare bezoekers; meest populair, trending en bestsellers, eventueel uit de categorie waar de bezoeker net naar keek; samen bekeken, samen gekocht en upsells verankerd aan het product dat bekeken wordt of in het mandje zit; bezoekersgeschiedenis zoals recent bekeken en weer op voorraad; catalogusgebeurtenissen zoals nieuwe binnenkomers en prijsdalingen; en een eigen algoritme dat je zelf definieert. Zie de pagina over de aanbevelingsengine voor de volledige set.
- De instellingen van de eigenaar. Hier woont de bedrijfslogica van een site. Een uitgever kan gepromote of gesponsorde content zwaarder laten wegen; een retailer kan een categorie een boost geven, uitsluiten wat niet op voorraad of al gekocht is, de prijsklasse begrenzen en een item op positie één vastzetten. Gewichten per algoritme bepalen de mix; filters bepalen wat er überhaupt mag verschijnen.
- Per doelgroep. Dezelfde widget kan voor verschillende doelgroepen verschillende logica draaien — complete-the-look voor terugkerende kopers, bestsellers voor nieuwe bezoekers — omdat de targetingstap al heeft vastgesteld wie dit is.
- Gestuurd door het bezoek. De interesses uit deze sessie veranderen de rangschikking meteen: een bezoeker die net drie items in één categorie heeft bekeken, ziet die categorie zwaarder wegen nog voordat hij de huidige pagina verlaat.
5. Testen en optimaliseren: welke variant, voor wie
Als een campagne een experiment is, gebeurt de toewijzing hier. Personyze wijst per doelgroep toe en bepaalt de uitkomst per doelgroep, en dat is het verschil tussen A/B-testen vanuit de doelgroep en de variant voor de hele site: een variant kan winnen bij terugkerende shoppers en verliezen bij nieuwe bezoekers, en de engine kan hem promoveren voor de eerste groep terwijl de test voor de tweede doorloopt. Multivariate tests doen hetzelfde over meerdere elementen tegelijk, en aanbevelingsalgoritmen kunnen op dezelfde plaatsing tegen elkaar worden getest, gemeten aan omzet per sessie in plaats van klikken.
De omgeving telt ook. Een campagne wordt gebouwd en bekeken in staging, live gezet als hij klaar is en verdeeld op verkeerspercentage, zodat een nieuw idee eerst op een deel van het verkeer kan draaien voordat het op iedereen draait. Als de cijfers binnen zijn, neemt de winnaar automatisch het verkeer over.
6. De weergave: snel genoeg dat niemand het merkt
Pas nu verschijnt er iets. De gekozen acties worden weergegeven in de pagina via de tag op je eigen site, server-side op een dynamische landingspagina, in een e-mail op het moment dat die wordt geopend, als pushmelding, in het chatgesprek, via de API voor je eigen stack, of als event naar Meta, TikTok, Google Analytics en de rest van de twaalf bestemmingen die de event sender bereikt — en de hele keten hierboven moet klaar zijn voordat de pagina geladen is. Niets wacht op een batchjob: het speurwerk achter de ontdekking liep dagen geleden, de lijsten zijn ’s nachts ververst, en de beslissing zelf wordt op het moment van het verzoek berekend uit het live profiel.
7. Leren: wat er terugkomt
De laatste laag voedt de eerste. Elke vertoning, klik en conversie wordt teruggeschreven naar het profiel, wat verandert waarvoor de bezoeker bij het volgende verzoek in aanmerking komt. Campagnerapporten tonen resultaten per doelgroep, per actie, per algoritme en per variant, niet alleen per campagne, zodat de vraag “werkte dit?” een antwoord heeft voor elke groep waaraan het werd getoond. Winnaars worden gepromoveerd; algoritmen krijgen gewicht naar wat ze opleveren.

Dezelfde eerlijkheid geldt voor wat de engine zelf vond: voorspelde lift en gerealiseerde lift worden apart getoond, en een trechter telt welke doelgroepen zijn aangemaakt, gevuld en daadwerkelijk gebruikt. Voorbeeldaccount.
Waarom de lagen ertoe doen
Leveranciers die uit een testtool zijn gegroeid, beginnen meestal bij laag vijf; leveranciers die uit een aanbevelingswidget zijn gegroeid, beginnen bij laag vier. Beide plakken er achteraf een profiel aan, en daarom heeft hun “full stack” een integratieproject nodig om zich als één systeem te gedragen. Beginnen bij de data — standaard verzameld, begrepen door de crawler, uitgebreid met je integraties — maakt elke volgende laag goedkoop: de targetingregel, de aanbevelingsmix, de test en het rapport lezen allemaal hetzelfde profiel, en de site-eigenaar bepaalt bij elk ervan de regels.
- Het personalisatieplatform — één profiel, één engine, elke toepassing.
- Gedragsgerichte targeting — de regels, de triggers, de kanalen.
- De aanbevelingsengine — de algoritmen en de instellingen die ze sturen.
- A/B-testen vanuit de doelgroep — toewijzing en uitkomst per doelgroep.
- Doelgroepontdekking — de doelgroepen die de engine in je eigen data vindt.
- Boek een demo — zie de beslissing op je eigen pagina’s.
Book a demo with a personalization expert
30 minutes with a personalization expert. Bring your stack, your goals, your skepticism. We'll show you what changes when every visit feels like the only one.